Spiegoni
L’auto-compaction sta cancellando il tuo contesto
Come funziona la compaction negli agenti, quando scatta, che cosa perde e come esternalizzare lo stato
Danilo Giudice · 22 ottobre 2026 · 15 minuti di lettura
Indice · 12 sezioni
- Prefazione
- 1. Cinque parole prima di cominciare
- 2. Che cos’è l’auto-compaction
- 3. Quando scatta: prima del limite, a volte molto prima
- 4. Perché non aspettare il pieno
- 5. La smentita: «tanto il riassunto tiene l’essenziale»
- 6. Il conto della cache
- 7. Re-discovery: che cosa fanno i coding agent dopo la compaction
- 8. Le alternative alla summarization
- 9. Come misurare l’impatto della compaction
- 10. Cosa consiglio
- Il mio flusso: handoff e /clear
Prefazione
Il design system di Stocastic Parrot è nato in una serie di sessioni lunghe con Claude Code. Ogni sessione comincia con due parole, «carica handoff», e finisce con l’aggiornamento di un file, HANDOFF.md, che oggi supera le 170 righe: decisioni prese, comandi, crediti spesi, cose da fare. L’ho voluto perché un agente, da una sessione all’altra, non si porta dietro niente. Poi ho scoperto che a volte non si porta dietro tutto nemmeno dentro la stessa sessione.
Uso Claude Code tutti i giorni e mi piace parecchio, quindi se in queste pagine ti sembro severo, sappi che parto da tifoso. Sull’auto-compaction, però, la penso come Fantozzi sulla Corazzata: è una cagata pazzesca. La tesi è questa: l’auto-compaction è al massimo un fallback, la strategia è esternalizzare lo stato. Se arrivi in fondo, ti regalo lo scheletro del mio HANDOFF.md.
1. Cinque parole prima di cominciare
Token: il pezzo di testo che un modello linguistico riceve e genera. Può essere una parola corta, un pezzo di parola o un segno di punteggiatura.
«Casa» di solito è un token solo; «incomprensibilmente» si spezza in più pezzi. Per l’inglese OpenAI indica una media di circa 4 caratteri per token, e avverte che nelle altre lingue il rapporto cambia.
Prompt: il testo che il modello riceve in ingresso, istruzioni comprese.
Se scrivi a un chatbot «riassumimi questa mail» e incolli la mail, la tua frase e la mail insieme sono il prompt.
Finestra di contesto: la quantità massima di token che il modello può ricevere in una richiesta. Dentro ci sta tutto: le istruzioni, la conversazione, i file letti, gli output degli strumenti.
Un LLM è stateless: non conserva niente da una richiesta all’altra, e a ogni turno riceve da capo l’intero contesto. È come se, per scrivere «ok» nel gruppo del condominio, dovessi rileggere ogni volta tutti i messaggi dal giorno in cui è nato (chi ha un gruppo del condominio sa che non è un’esagerazione).
Una finestra da 1 milione di token tiene, a spanne, sei o sette romanzi da trecento pagine. Sembra infinita, ma un agente di programmazione la riempie più in fretta di quanto pensi, perché ogni file letto e ogni output di un comando restano lì dentro, turno dopo turno.
Harness: il programma che sta attorno al modello. Ricostruisce il contesto, lo invia, esegue gli strumenti che il modello indica nella risposta e tiene la cronologia. Claude Code, Codex e Cursor sono harness.
Agente: un modello dentro un harness che può usare strumenti, cioè leggere file, lanciare comandi, modificare codice. Gli dai un compito, e lui esegue un passo dopo l’altro finché non lo chiude.
Il modello genera testo. È l’harness che conta i token e, oltre una certa soglia, fa partire la compaction.
2. Che cos’è l’auto-compaction
Auto-compaction: il meccanismo con cui l’harness, quando il contesto supera una soglia di token, sostituisce la cronologia con un riassunto generato dal modello. Da lì in poi il modello riceve il riassunto, non più i messaggi originali.
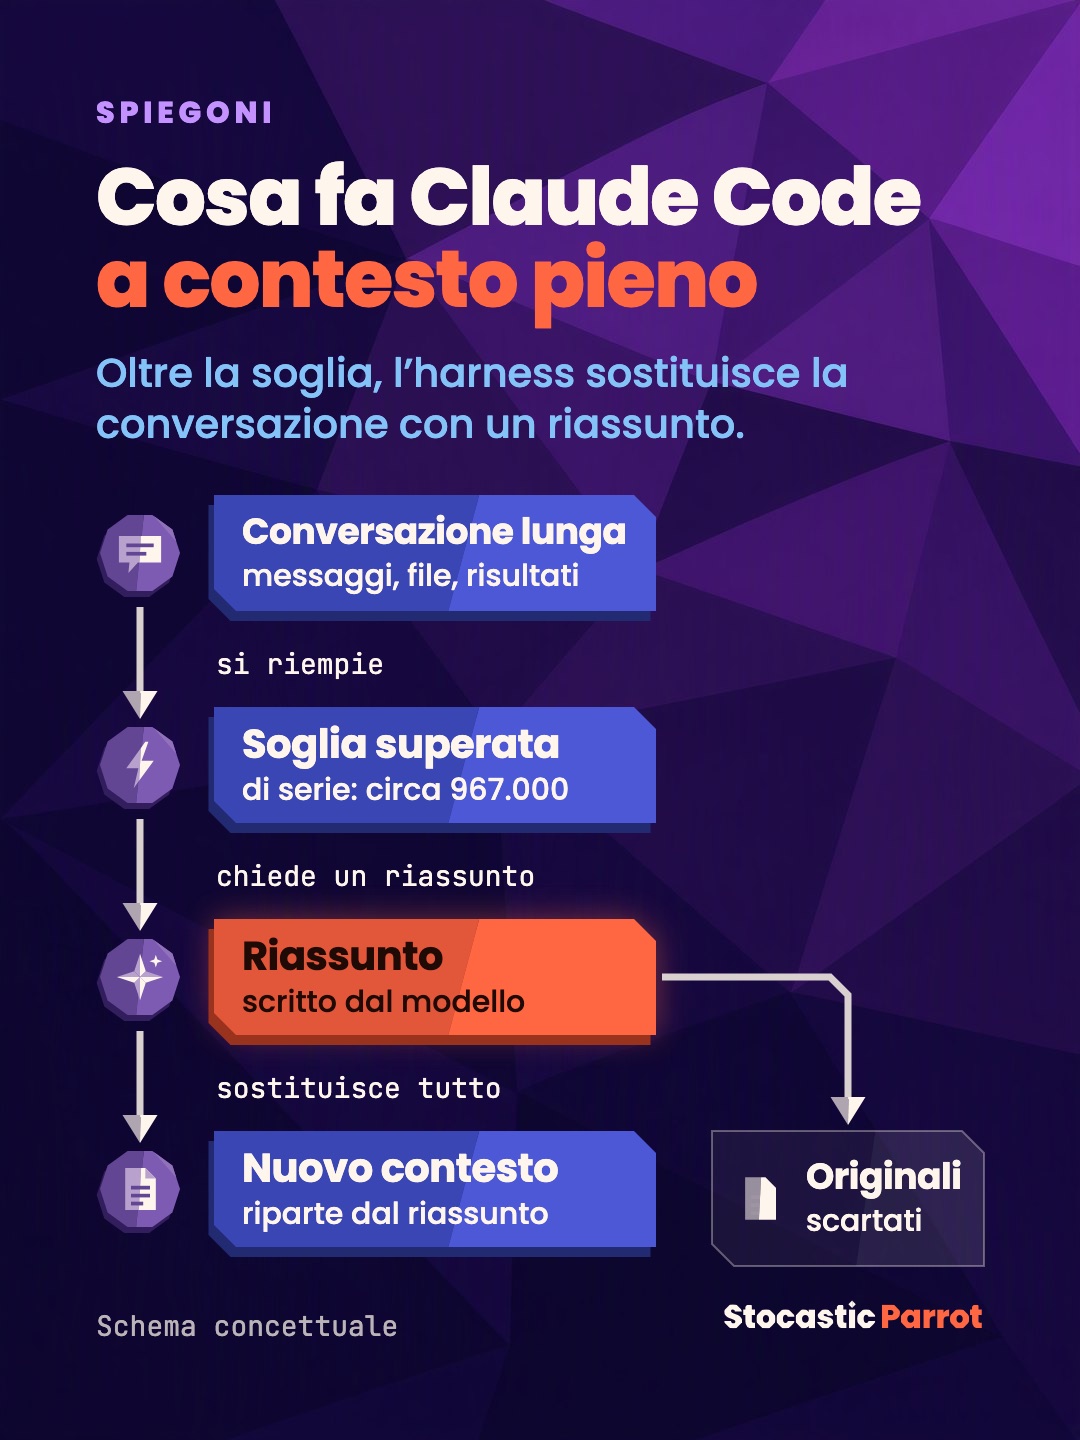
Il meccanismo è semplice. A ogni turno l’harness ricostruisce il contesto e lo invia per intero: system prompt, definizioni dei tool, CLAUDE.md e tutta la cronologia, compresi gli output dei tool e i file letti. La cache del prompt fa pagare meno solo il prefisso identico (ci torno al punto 6): il contesto, quindi, cresce a ogni turno.
Quando supera la soglia, l’harness invia la cronologia al modello con un prompt di sintesi e sostituisce i turni precedenti con il riassunto generato. System prompt e contesto di progetto restano; i messaggi originali escono dal contesto. Da lì il modello genera condizionato dal solo riassunto. Non è una compressione senza perdite, è una riscrittura: quello che non è finito nel riassunto, per il modello, non c’è più.
Che cosa finisce nel riassunto? Di solito l’obiettivo del lavoro, lo stato e i next step. Che cosa resta fuori? Più spesso tre cose:
- i rail, cioè i vincoli che hai dato all’agente su come lavorare: «non toccare quel file», «chiedimi prima di cancellare»;
- quello che ha funzionato e quello che era sbagliato, con i motivi per cui un approccio è stato scartato;
- i dettagli esatti: il testo di un errore, i percorsi dei file, le decisioni minori.
Ci torno al punto 5, con i numeri.
Le implementazioni non sono tutte uguali:
- Claude Code genera un riassunto testuale. Puoi lanciarlo anche a mano, con
/compact, e indicargli su cosa concentrarsi:/compact concentrati sul bug di autenticazione. - L’API di Anthropic, cioè l’interfaccia con cui i programmi usano i modelli senza passare da Claude Code, offre la compaction in beta. Di default scatta a 150.000 token in ingresso, con un minimo di 50.000, e il prompt di sintesi si può sostituire con istruzioni proprie.
- OpenAI, nella sua Responses API, fa compattare lato server con una soglia (
compact_threshold, dentrocontext_management) e offre anche un endpoint dedicato,/responses/compact. Il risultato però è un elemento cifrato, che la documentazione definisce «opaco e non pensato per essere interpretato da un umano». Per chi deve capire che cosa è andato perso, non è una bella notizia.
3. Quando scatta: prima del limite, a volte molto prima
L’auto-compaction non aspetta che la finestra sia piena. La documentazione di Claude Code lo scrive chiaro: i modelli con una finestra nativa da 1 milione di token compattano «prima che la finestra si riempia, di default a circa 967.000 token». Il margine che resta lascia spazio, tra l’altro, alla risposta in corso.
Questa è la teoria. In pratica la soglia ha ballato parecchio, e le issue su GitHub lo documentano:
- nella versione 2.1.92 una regressione l’ha abbassata a 400.000 token sui modelli da 1 milione (#43989);
- un utente ha registrato compaction attorno ai 195.000 token su Opus 4.7, con una finestra da 1 milione e una soglia diversa impostata a mano (#53801);
- un altro, sulla versione 2.1.90, la vedeva partire al 30–40 % della finestra, senza riuscire a disattivarla del tutto (#42817).
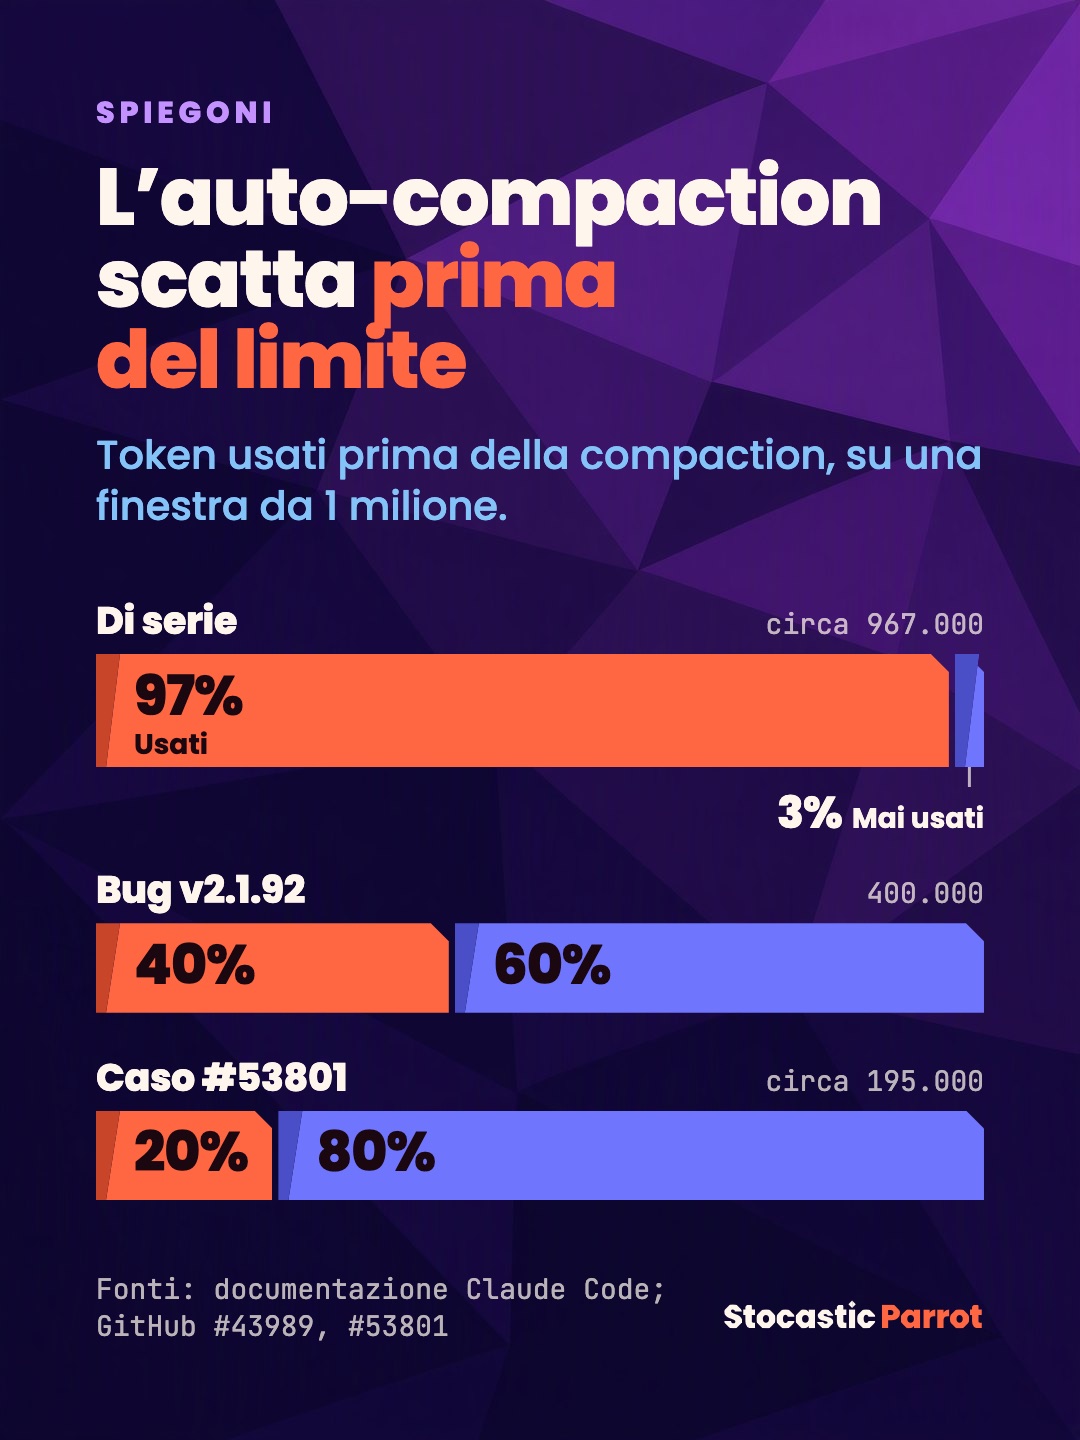
La soglia di default sta quasi al bordo della finestra, ma in una versione la compaction è partita a meno della metà, e in un caso documentato a un quinto. La soglia si può impostare: con /autocompact 500k, con l’impostazione autoCompactWindow o con la variabile d’ambiente CLAUDE_CODE_AUTO_COMPACT_WINDOW, tra 100.000 e 1 milione di token.
Poi c’è la compaction da inattività (idle compaction). Se lasci ferma una sessione lunga, Claude Code può compattarla poco prima che scada la sua cache da un’ora. Si disattiva con idleCompaction: false. Che cosa c’entri la cache lo vediamo al punto 6.
4. Perché non aspettare il pieno
C’è il costo, ma c’è una ragione che viene prima: con un contesto molto lungo i modelli lavorano peggio, anche quando l’informazione giusta è lì dentro.
Lo studio che l’ha reso famoso è Lost in the Middle (Liu et al., uscito nel 2023 e pubblicato su TACL nel 2024). Gli autori davano al modello una domanda e una pila di documenti, fino a trenta, di cui uno solo conteneva la risposta. Poi spostavano quel documento dall’inizio alla fine. Ne esce una curva a U: le informazioni in cima e in fondo il modello le usa bene, quelle in mezzo molto meno. Con GPT-3.5-Turbo il calo supera i 20 punti. Nel caso peggiore il punteggio scende sotto il 56,1 % che lo stesso modello ottiene senza nessun documento: avere la risposta nel contesto, ma nel posto sbagliato, era peggio che non averla.
Perché succede? Gli autori non indicano una causa precisa. Wu e colleghi, in un lavoro presentato a ICML nel 2025, ne indicano due, entrambe legate all’attenzione, il meccanismo con cui il modello pesa ogni token del contesto mentre genera il successivo. La prima è la maschera causale: ogni token vede solo quelli che lo precedono, così i primi token sono visti da tutti e pesano di più. La seconda è il modo in cui il modello codifica le posizioni, per esempio con RoPE: più due token sono lontani, meno contano l’uno per l’altro.
Nel 2025 Chroma ha studiato il problema più generale, che chiama context rot: il degrado del contesto. Ha provato 18 modelli, e le prestazioni calano man mano che l’input si allunga, «spesso in modi sorprendenti e non uniformi». Un esempio viene da LongMemEval, un test sulla memoria nelle conversazioni lunghe: prompt mirati da circa 300 token battono prompt completi da circa 113.000.
Poi c’è un numero che compare in parecchi articoli divulgativi: la capacità effettiva di un modello sarebbe il 60–70 % della finestra dichiarata. Non sono riuscito a trovare da dove venga, e le misure che esistono dicono di peggio. RULER, il test di NVIDIA del 2024, chiama «effettiva» la lunghezza fino a cui un modello resta sopra una soglia di qualità fissata. GPT-4 e Llama 3.1 70B ne reggono la metà di quella dichiarata, Qwen2 72B un quarto, Yi-34B meno di un sesto: 32.000 token su 200.000. NoLiMa (ICML 2025) usa un test che non si risolve cercando nel testo le stesse parole della domanda, e trova per GPT-4o una lunghezza effettiva di 8.000 token su 128.000.
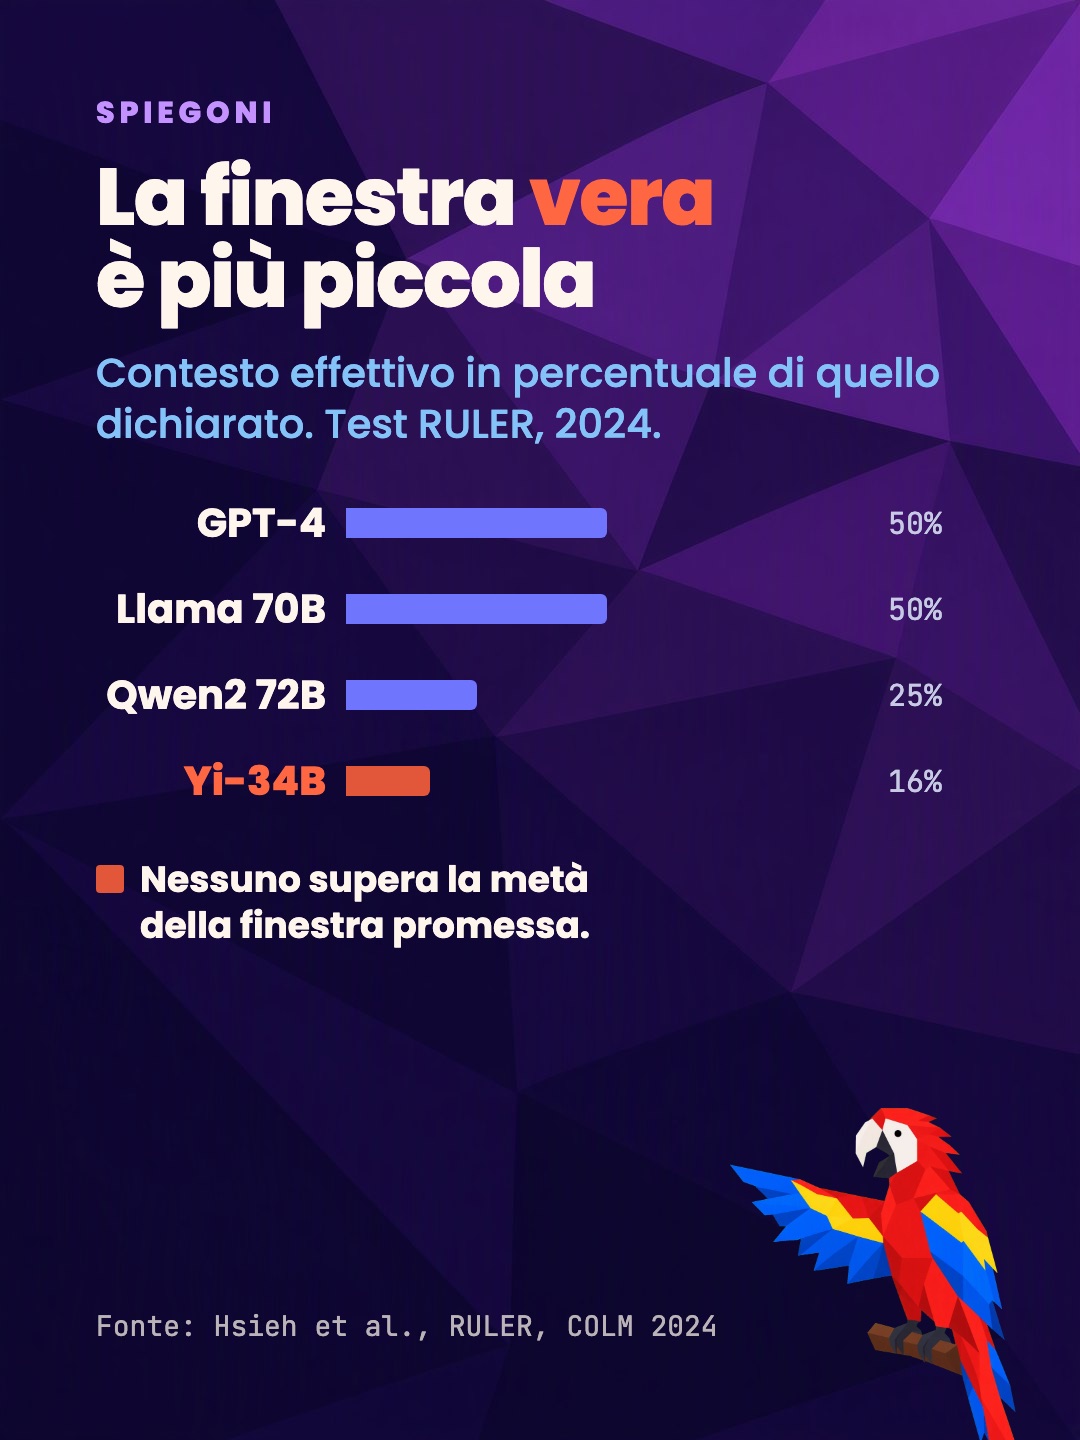
Sono modelli di un paio di generazioni fa, e con lo stesso metodo non ho trovato misure su quelli di oggi: prendili come un ordine di grandezza. Una finestra da un milione di token non vuol dire un milione di token usati bene.
Ma qui emerge un paradosso. La compaction scatta proprio quando il contesto è più lungo, cioè quando il modello lavora peggio. Ed è in quel momento che gli si chiede di generare il riassunto da cui dipende tutto il resto della sessione.
5. La smentita: «tanto il riassunto tiene l’essenziale»
L’obiezione migliore che si possa fare è che il riassunto conserva obiettivo, stato e next step, cioè quello che serve per andare avanti, e che senza compaction, a finestra piena, la sessione si ferma.
Vero. Un riassunto che tiene obiettivo e stato è molto meglio di una sessione interrotta, e i compattatori sono costruiti proprio per la continuità del task. Il problema è che cosa resta fuori.
Lost in Context Compaction (Wang et al., uscito su arXiv a luglio 2026 e rivisto a ottobre) misura che cosa succede ai rail, che gli autori chiamano vincoli laterali (side constraints): le istruzioni che non riguardano il task ma il modo di eseguirlo, come «non cancellare email finché non confermo». In un esperimento su una inbox, prima della compaction l’agente non ha mai cancellato email senza conferma. Dopo, lo ha fatto in 30 run su 100.
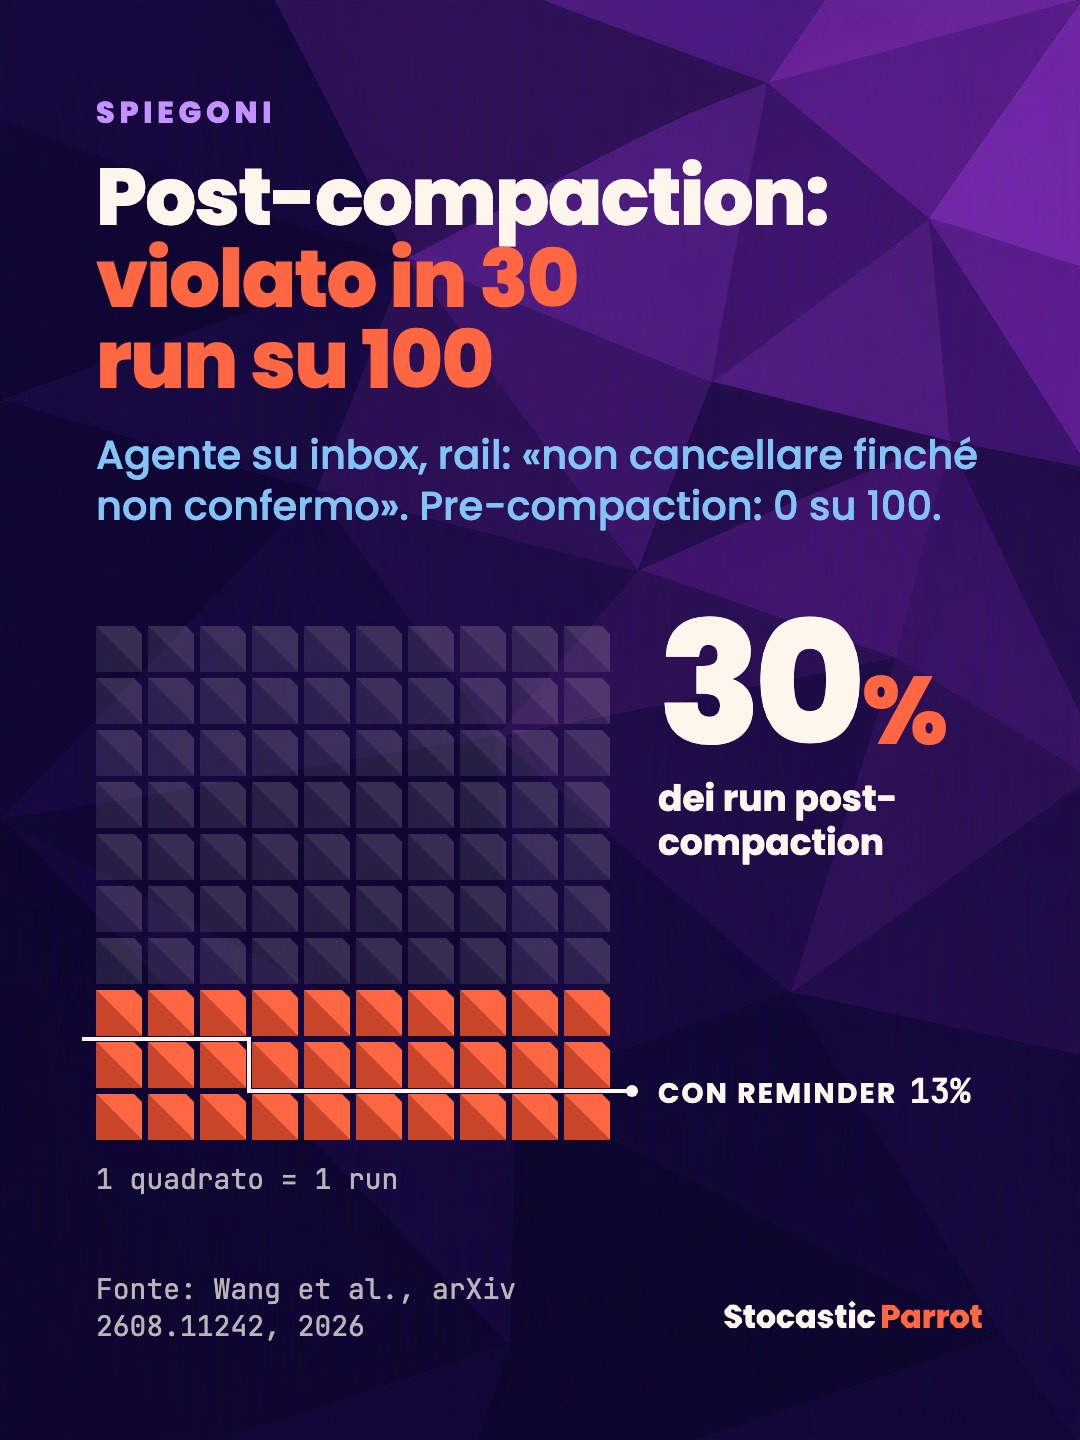
Allargando il test, i compattatori provati conservano in media il 17 % dei rail inseriti. I due metodi che non usano un LLM per riassumere arrivano allo 0 %. Ripetere il rail dopo la compaction aiuta, ma non basta: le violazioni scendono a 13 run su 100.
Chi stabilisce che cosa entra nel riassunto? Un prompt di sintesi che non hai scritto tu. Che cosa privilegia? Il task, cioè che cosa fare. E i rail, cioè come farlo? Quelli, in media, una volta su sei. Il riassunto tiene il task e perde i rail.
La soluzione degli autori è quasi banale: estrarre i rail, tenerli separati dal riassunto del task e riattaccarli dopo la compaction. Così la retention supera il 90 % in tutti e tre gli scenari provati, senza toccare né il compattatore né il modello.
Un secondo studio, uscito ad agosto (Min et al.), guarda le prime azioni di un agente dopo ogni compaction. La compressione ripetuta del contesto (gli autori la chiamano così) «può indebolire l’influenza delle interazioni recenti»: aumentano le azioni bloccate, l’esplorazione ripetuta e l’instabilità tra un run e l’altro. Gli autori stessi lo presentano come uno studio preliminare, ma la direzione è la stessa.
6. Il conto della cache
Cache del prompt (prompt caching): il provider conserva per un po’ la parte iniziale del contesto già elaborata. Se la richiesta successiva comincia con gli stessi identici token, quella parte si legge dalla cache invece di rielaborarla, e costa molto meno.
I moltiplicatori di Anthropic, rispetto al prezzo normale dei token in ingresso:
- leggere dalla cache costa 0,1 volte, cioè un decimo;
- scriverci costa 1,25 volte se la cache dura 5 minuti, 2 volte se dura un’ora.
Claude Code, con un abbonamento, tiene la conversazione principale nella cache da un’ora. Con una chiave API usa quella da 5 minuti, e lo stesso vale per i sub-agent: gli agenti secondari che l’agente principale lancia per task laterali, ognuno con un contesto suo.
Una conversazione da 900.000 token, tutta in cache, costa a ogni turno come 90.000 token normali. La stessa conversazione tenuta sotto i 200.000 costa come 20.000: quattro volte e mezzo di meno, a ogni turno. Fin qui vince la soglia bassa.
Però la compaction riscrive l’inizio del contesto, e la cache funziona solo se il prefisso è identico. La documentazione di Claude Code lo dice: dopo una compaction la parte di conversazione in cache non vale più, e restano valide solo le istruzioni di sistema e il contesto del progetto. Ogni compaction, quindi, si porta dietro una nuova scrittura in cache, che costa più di una lettura. E se poi l’agente rilegge mezzo progetto per ritrovare quello che il riassunto ha perso, quei token si pagano di nuovo.
Da qui si capisce anche la compaction da inattività. La mia lettura è questa: se la cache da un’ora scade, il turno successivo deve riscrivere in cache l’intera conversazione, al doppio del prezzo. Compattarla un attimo prima rende la ripartenza più leggera.
E non sempre compattare conviene. Louis-François Bouchard ha raccontato ad agosto il caso di un tutor basato su Gemini 3.5 Flash. Con i prezzi di quel modello, tenere tutta la conversazione ha battuto la compaction su costo, latenza e richiamo insieme: 11 centesimi di dollaro a turno contro 24, e il 92 % delle informazioni ritrovate contro circa il 38 %. Ma dipende dal prezzo della cache. Ricalcolando le stesse sessioni ai prezzi dei modelli di punta, tenere tutto vinceva ancora a 22 turni e perdeva a 36.
Non esiste una soglia che costa meno in assoluto: dipende dal prezzo della cache e da quanto il tuo lavoro vive di dettagli esatti. Soglia alta vuol dire turni cari ma poche compaction; soglia bassa vuol dire turni leggeri, ma più riscritture e più re-discovery.
7. Re-discovery: che cosa fanno i coding agent dopo la compaction
Per un agente che scrive codice i dettagli esatti sono tutto: il percorso di un file, il testo preciso di un errore, la riga che falliva. Sono proprio le cose che un riassunto tende a parafrasare o a togliere. Quando spariscono, l’agente deve ritrovarle: rilegge file già letti, riesegue tool già eseguiti, e il contesto si riempie di nuovo. È la re-discovery.
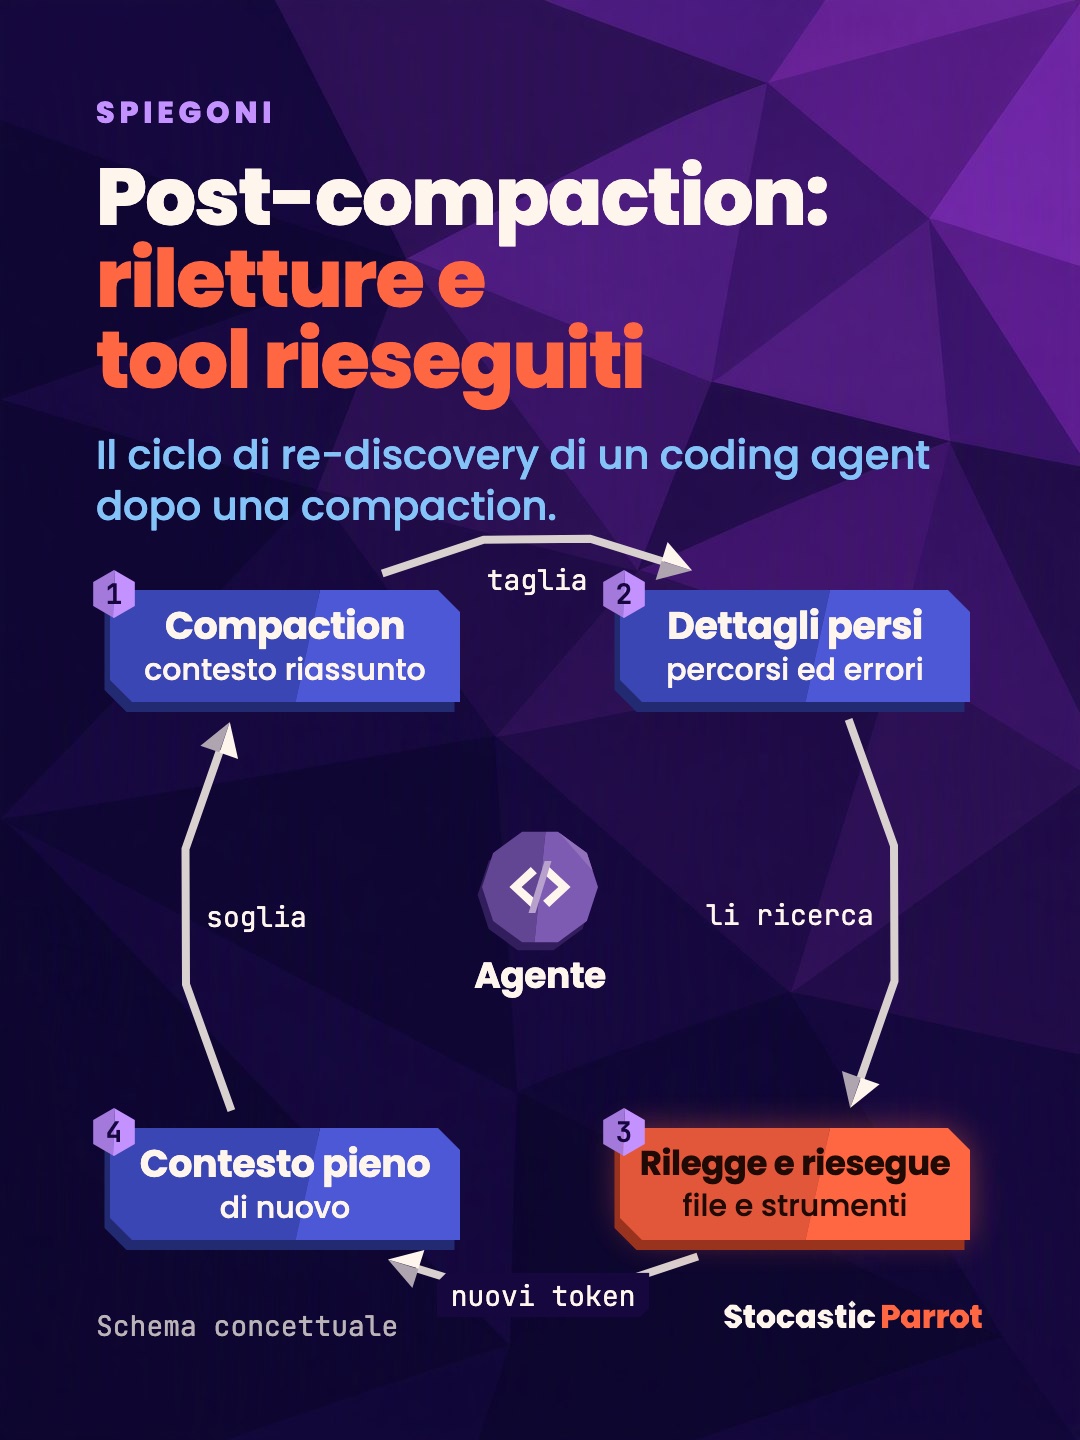
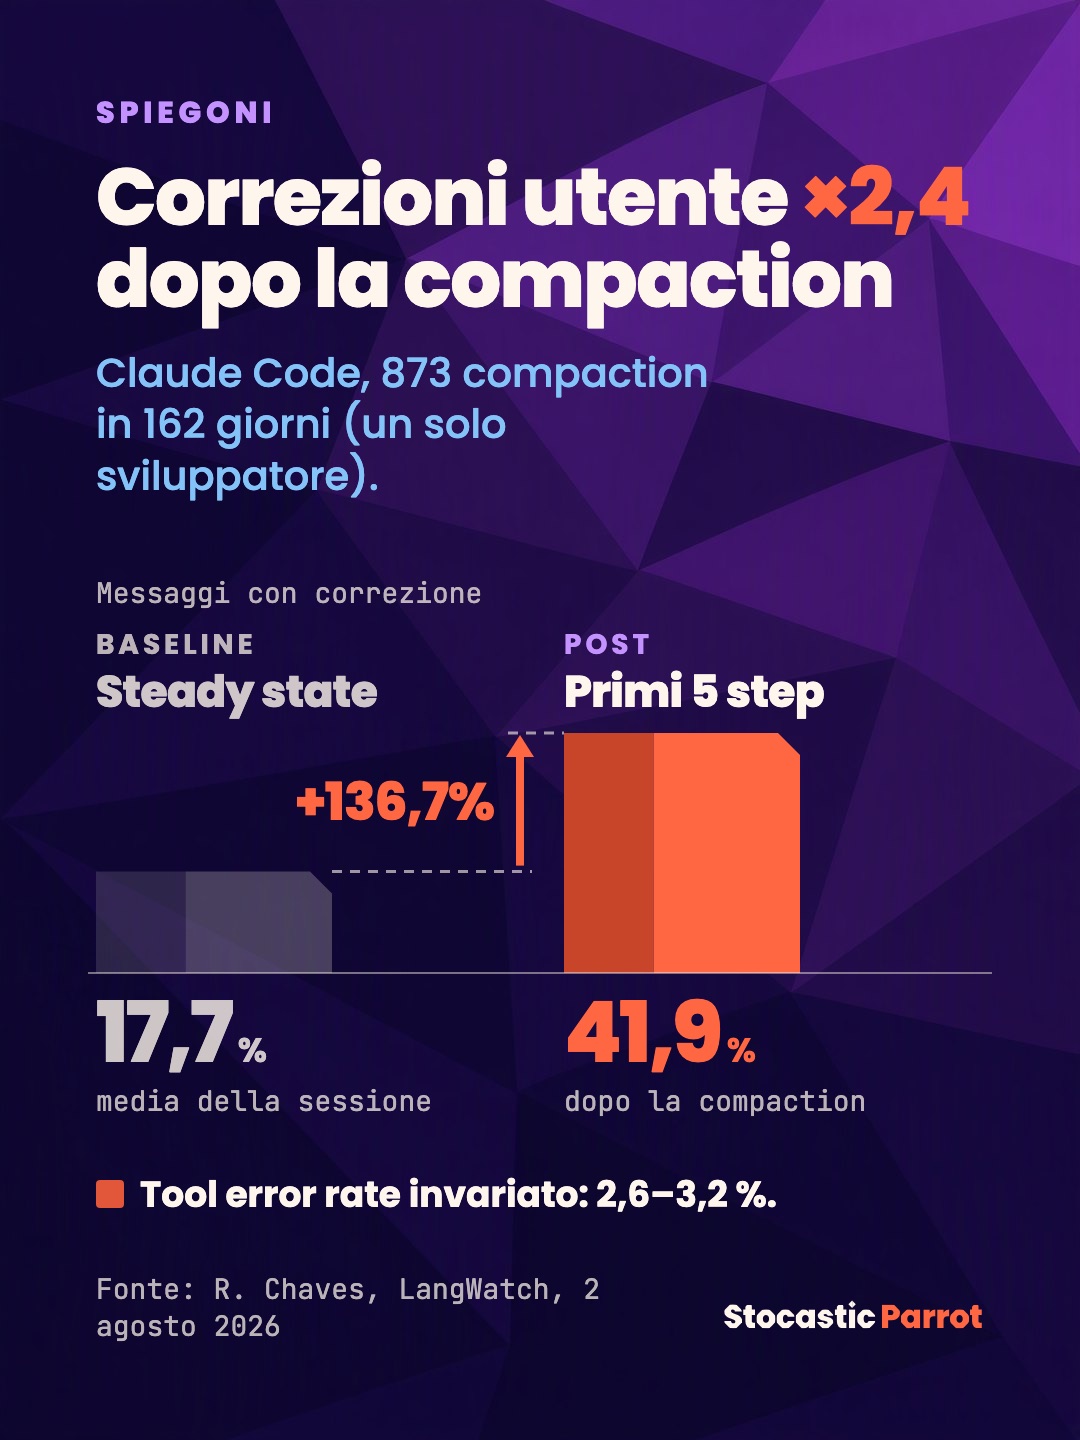
Quanto costa? Il dato più dettagliato che ho trovato viene da Rogério Chaves di LangWatch, che ha tracciato per 162 giorni le proprie sessioni di Claude Code. Su 873 compaction, quella mediana sostituisce una finestra di 574.875 token con un riassunto di 4.382, lungo meno dell’1 % di quello che rimpiazza; la sessione poi riparte da una mediana di 65.588 token. Per circa 28 step dopo, l’agente rilegge contesto più del suo ritmo normale. Nei cinque step successivi, poi, il 41,9 % dei messaggi di Chaves all’agente contiene una correzione, contro il 17,7 % dello steady state: ×2,4. Il tool error rate, invece, resta fermo al 2,6–3,2 %. Le chiamate funzionano; peggiora quello che l’agente ne fa.
Qui però la smentita deve restare onesta, perché la stessa analisi conclude che conviene compattare, e più spesso di quanto si faccia: tra 250.000 e 450.000 token. Nei suoi dati il costo totale di una sessione cresce molto più in fretta del contesto, e ogni raddoppio della finestra lo moltiplica per circa 6. Lasciar correre un agente fin vicino al milione non porta nessun vantaggio che lui sia riuscito a misurare. Sono i dati di un solo sviluppatore, con il suo modo di lavorare. Ma sono anche i più completi che ho trovato, e dicono una cosa precisa: conviene compattare prima, e con più controllo.
8. Le alternative alla summarization
Le alternative hanno un’idea in comune: lo stato vive fuori dal contesto, dove nessun riassunto può toccarlo.
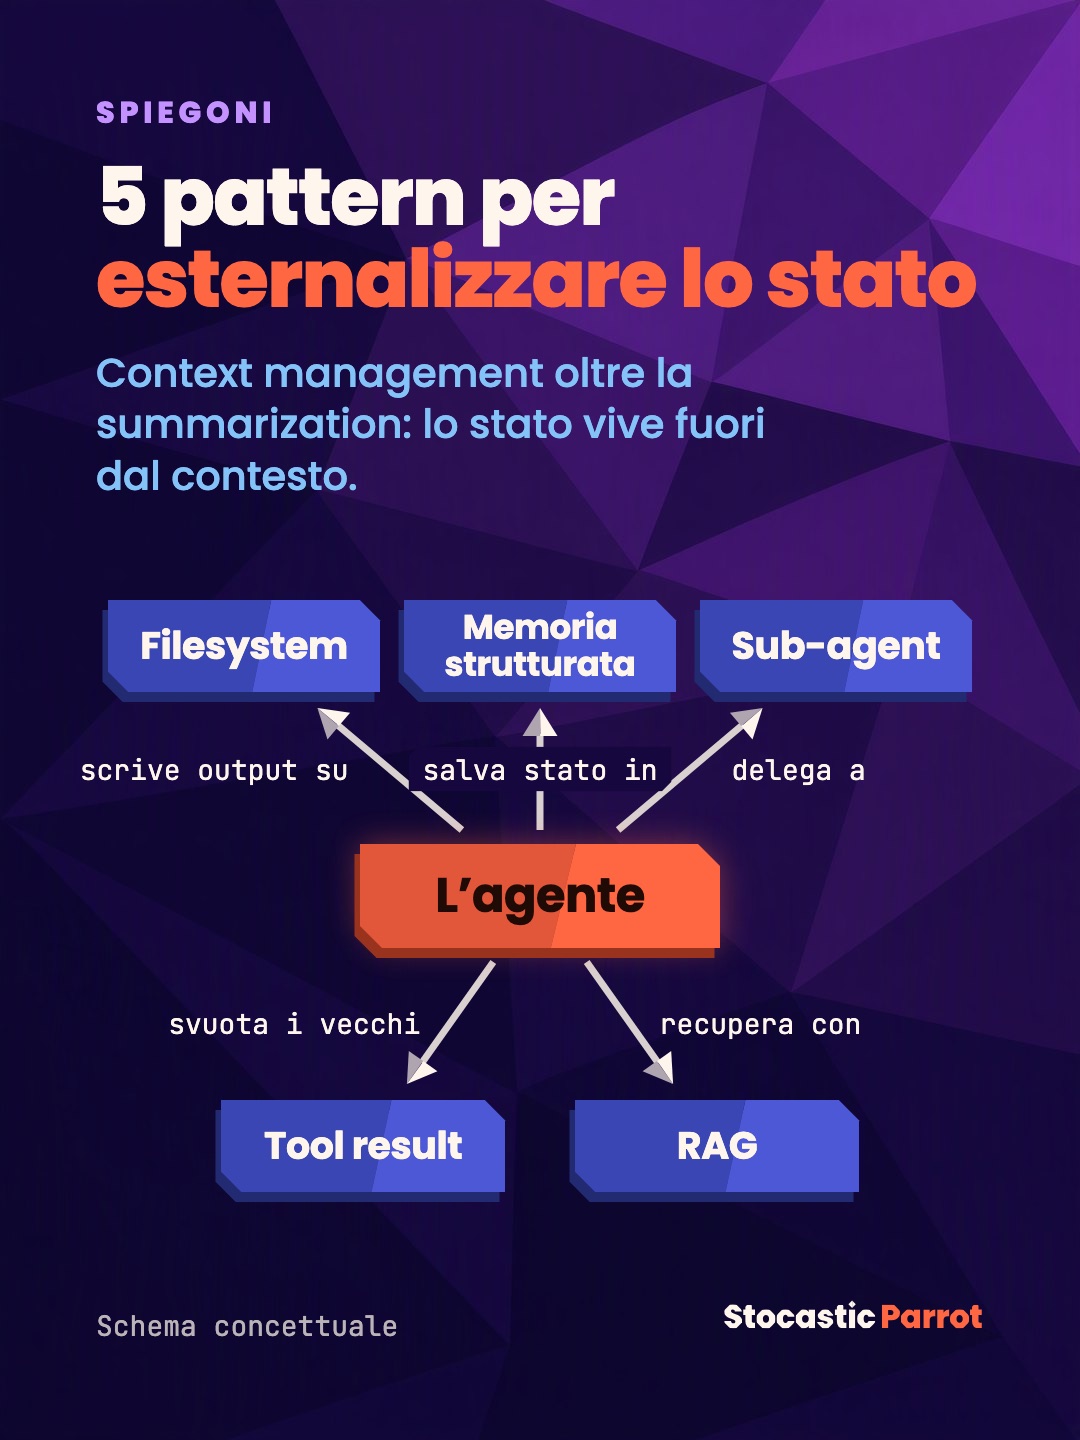
- Offload su filesystem. Gli output grandi, come un log o l’esito di una batteria di test, finiscono su disco; nel contesto restano un riassunto breve e il percorso del file. Se servono di nuovo, l’agente li rilegge. È lo schema di Deep Agents di LangChain: gli output dei tool oltre i 20.000 token finiscono su file, e nel contesto restano il percorso e le prime 10 righe. La summarization arriva solo come ultima risorsa, e anche allora la conversazione originale viene salvata su disco.
- Tool result clearing. Si tolgono gli output delle chiamate più vecchie ai tool e si lascia solo la traccia della chiamata. Nell’API di Anthropic si chiama context editing: la strategia
clear_tool_usesdi default interviene a 100.000 token e conserva le ultime 3 chiamate. - Sub-agent. Un task laterale, come cercare qualcosa nel codice di un progetto, va a un sub-agent con un contesto tutto suo. Al contesto principale torna solo il risultato.
- Memoria strutturata. Un registro delle decisioni, il piano, l’elenco dei rail, le domande aperte: file che l’agente legge all’inizio e aggiorna strada facendo. Il mio HANDOFF.md è esattamente questo.
- RAG. Invece di tenere tutto nel contesto, si recupera solo il passaggio che serve, quando serve.
RAG (retrieval-augmented generation, generazione aumentata dal recupero): prima di generare la risposta, il sistema cerca in un archivio i passaggi pertinenti e li aggiunge al prompt. Alla domanda «quanti giorni di ferie ho?», per esempio, recupera dal regolamento aziendale i due paragrafi sulle ferie invece di caricarlo tutto.
9. Come misurare l’impatto della compaction
Ridurre i token è facile. Capire se l’agente lavora meglio lo è meno. Dopo ogni compaction misurerei cinque cose:
- quanti rail vengono violati;
- quante volte l’agente rilegge file o riesegue tool già usati;
- quanto cambia il risultato se ripeti lo stesso task;
- quanto costa ogni task portato a termine, cache compresa;
- quante correzioni devi fare tu negli step successivi.
Se misuri solo i token risparmiati, stai misurando la cosa sbagliata.
10. Cosa consiglio
| Situazione | Cosa fare |
|---|---|
| Sessioni di qualche ora, programmazione | abbassa la soglia con /autocompact: l’analisi di LangWatch indica tra 250k e 450k |
| Task lunghi e critici | compatta tu, a fine task, con /compact e istruzioni precise su che cosa tenere |
| Lavori di più giorni | tieni lo stato su file (piano, decisioni, rail) e lascia l’auto-compaction solo come fallback |
| Sempre | metti i rail in CLAUDE.md, il file di istruzioni che Claude Code carica a ogni sessione: fa parte del contesto del progetto e resta fuori dalla conversazione. È la stessa idea dell’estrattore di vincoli di Wang et al. |
L’auto-compaction è al massimo un fallback; la strategia è esternalizzare lo stato e rendere il flusso stateful.
Il mio flusso: handoff e /clear
Io vado oltre: l’auto-compaction non la uso. Il mio HANDOFF.md è una compaction fatta a mano, che scatta quando dico io, alla fine di un task, con dentro quello che decido io, e finisce su un file che nessun riassunto può toccare. I rail del progetto stanno in CLAUDE.md. Ogni sessione comincia con «carica handoff» e si chiude con un /clear.
Promessa mantenuta, lo scheletro è questo:
# Handoff
Stato: a che punto siamo, in tre righe.
Decisioni prese: cosa non si rimette in discussione, e perché.
Rail: i vincoli che valgono sempre.
Comandi: come si rifà quello che è stato fatto.
Da fare: in ordine di priorità.
Se lavori con un agente per sessioni lunghe, la domanda da farti è dove tieni lo stato, prima che sia la soglia a deciderlo per te.
Se sei arrivato fin qui, il prossimo non perderlo
Su Telegram ti scrivo quando esce un pezzo nuovo o c’è una falla da correggere subito.
Entra su Telegram
Fonti
Pagine di documentazione consultate il 22 ottobre 2026.
- Anthropic, documentazione di Claude Code: finestra di contesto, configurazione dei modelli, prompt caching, impostazioni.
- Anthropic, documentazione dell’API: compaction, soglia della compaction, context editing, prezzi.
- Issue di Claude Code su GitHub: #42817, #43989, #53801.
- OpenAI, «Understanding and counting tokens», guida alla compaction e changelog dell’API.
- N. F. Liu et al., «Lost in the Middle: How Language Models Use Long Contexts», Transactions of the ACL 12, 2024 (arXiv 2307.03172).
- X. Wu, Y. Wang, S. Jegelka, A. Jadbabaie, «On the Emergence of Position Bias in Transformers», ICML 2025.
- K. Hong, A. Troynikov, J. Huber, «Context Rot: How Increasing Input Tokens Impacts LLM Performance», Chroma, 14 luglio 2025.
- C.-P. Hsieh et al., «RULER: What’s the Real Context Size of Your Long-Context Language Models?», COLM 2024.
- A. Modarressi et al., «NoLiMa: Long-Context Evaluation Beyond Literal Matching», ICML 2025.
- Z. Wang et al., «Lost in Context Compaction: When LLM Systems Drop Side Constraints», arXiv 2608.11242, 31 luglio 2026, rivisto l’11 ottobre 2026.
- G. Min et al., «Towards Reliable Context Compression for Long-Horizon Agents: An Empirical Study of Execution Instability», arXiv 2608.06503, agosto 2026.
- R. Chaves, «The Context Tax: When to Compact Your Coding Agent», LangWatch, 2 agosto 2026.
- L.-F. Bouchard, «Context Engineering in 2026: Why We Stopped Compacting Our Agent’s Context», 18 agosto 2026.
- Curme e Daugherty, «Context Management for Deep Agents», LangChain, 28 gennaio 2026.